Где найти проблемы сайта

О чем статья?
Сайт в топ-3 Google по нужному запросу, индексация в порядке, ссылки в порядке. Клиент спрашивает: почему ChatGPT не знает про мою компанию? В Search Console и Яндекс.Вебмастере всё зелёное.
Это реальный разбор, который автор опубликовал на Хабре в июле 2026 года. Причину нашли за пять минут в логах: в robots.txt стоял запрет для всех ботов, кроме Googlebot и YandexBot. GPTBot, ClaudeBot и PerplexityBot получали ошибку 403 на первом же запросе, и полгода сайт был невидим для трёх из четырёх крупных ИИ-поисковиков. Это один случай от практика, а не статистика. Но он показывает главную ловушку: стандартные отчёты не показывают всё.
Ниже порядок поиска проблем от самых частых к самым скрытым.
С чего начинать
Порядок важен, потому что каждый следующий слой бессмыслен, если сломан предыдущий. Сначала проверяют, видит ли робот страницы вообще. Потом, что он на них видит. Потом дубли, скорость и, наконец, аналитику. Переписывать тексты при закрытой индексации это как красить фасад дома, у которого нет входа.
Если нашли много проблем сразу, начинайте с тех, что напрямую блокируют ранжирование: закрытая индексация, ошибки сервера 5xx, отсутствие HTTPS и массовые дубли. Их рекомендуют чинить в первую неделю. Экспресс-аудит из восьми пунктов (индексация, robots.txt, sitemap, случайные noindex, мобильная версия, скорость, редиректы, счётчики) занимает несколько часов.
Индексация: где смотреть и как читать
Три вещи, которые чаще всего читают неправильно:
- В индексе должны быть не все страницы, а только канонические. Копии и альтернативные версии в статусе «не проиндексировано» нормальны, если каноническая страница в индексе.
- Новый контент индексируется не мгновенно, иногда несколько дней.
- Статусы «Просканирована, но пока не проиндексирована» и «Обнаружена, не проиндексирована» означают разные вещи. Первый: Google страницу видел, но в индекс пока не добавил. Второй: адрес найден, но сканирование отложено, чтобы не перегружать сайт.
В таблице причин есть столбец «Источник»: «Сайт» или «Google». Как правило, самостоятельно устранить можно только проблемы с источником «Сайт». После исправления нажмите «Проверить исправление»: проверка обычно занимает около двух недель.
Что блокирует доступ
Самая частая путаница: robots.txt управляет сканированием, а noindex управляет индексированием. Если закрыть страницу в robots.txt и одновременно поставить на неё noindex, робот не зайдёт и тег не прочитает. Google в справке прямо предупреждает: страница, закрытая в robots.txt, всё равно может попасть в индекс по ссылкам с других сайтов, только сниппет будет скудным. Чтобы страницу действительно убрать из поиска, откройте её для сканирования и добавьте noindex.
Остальные типовые причины, которые ищут по шаблонам, а не по отдельным адресам:
- Ошибки 401 и 403. Googlebot никогда не передаёт учётные данные, поэтому закрытые паролем страницы он не проиндексирует.
- Ложная 404. Пользователь видит «страница не найдена», а сервер отвечает кодом 200. Робот считает такую страницу настоящей.
- Цепочки редиректов. Слишком длинная цепь или бесконечная переадресация останавливают индексацию. Отдельная беда: все старые адреса после переезда ведут на главную вместо близких по смыслу страниц.
- Sitemap с мусором. В карте сайта должны лежать только актуальные канонические адреса со статусом 200, без редиректов, дублей и страниц с noindex. Гарантий индексации карта не даёт.
- Canonical. Google может выбрать другую каноническую страницу, если остальные сигналы противоречат вашему указанию. Проверьте через «Проверку URL» пункт «Каноническая страница, выбранная Google».
- JavaScript. Откройте отрендеренную версию страницы в «Проверке URL» и сравните с исходным HTML: цены, характеристики, текст и ссылки должны быть на месте. Ссылки без нормального href, товары, которые появляются только после клика, и бесконечная прокрутка без постраничных адресов роботу не видны.
Дубли, мобильная версия и скорость
Дубли рождаются автоматически: варианты с www и без, http и https, слэш на конце, UTM-метки, сортировки, фильтры, страницы пагинации, внутренний поиск. Тысячи слабых адресов тратят ресурс сканирования вместо важных страниц. Инструмент Google для параметров URL закрыт ещё в 2022 году, поэтому регулировать приходится на стороне сайта: редиректами, canonical, правилами robots.txt и чистыми внутренними ссылками. Оставляйте индексируемыми только те фильтры, у которых есть спрос и нормальное содержание.
Мобильная версия проверяется просто: на смартфоне должны быть тот же основной текст, таблицы, цены, отзывы, ссылки и разметка, что и на десктопе. Google индексирует именно мобильный вариант.
По скорости ориентиры такие: LCP до 2,5 секунды, INP до 200 миллисекунд, CLS не выше 0,1. Приоритет отдавайте данным реальных пользователей, лабораторные используйте для диагностики. Причину обычно ищут в шаблоне страницы, а не в отдельном адресе: карточка товара, категория, статья. О самих порогах подробнее в статье про продвижение в Google без мифов.
Доступ для ИИ-краулеров
Это единственный пункт, которого нет в старых чек-листах, поэтому он стоит отдельно.
ИИ-краулеры делятся на два типа. Одни собирают данные для обучения моделей (например, GPTBot у OpenAI и ClaudeBot у Anthropic) и заходят редко. Другие работают в реальном времени: заходят на страницу в момент вопроса пользователя и отдают содержимое для ответа (например, OAI-SearchBot, PerplexityBot и ChatGPT-User). Если у такого бота нет доступа, модель либо не найдёт страницу, либо процитирует конкурента с открытым доступом. Список имён быстро растёт, поэтому актуальные названия сверяйте на страницах самих компаний хотя бы раз в квартал.
Хорошая новость: если про бота в robots.txt ничего не написано, доступ открыт. Плохая: доступ теряется в трёх других местах.
- WAF, CDN и защита от ботов. Файл может разрешать бота, а правило на уровне защиты сайта отрежет его по user-agent или IP. Проверяют также геоблокировки, лимиты запросов и настройки mod_security и Nginx.
- JavaScript без серверного рендеринга. Боты реального времени забирают HTML из первого ответа сервера. Если текст подгружается скриптом позже, они видят пустой каркас.
- Бесконечная прокрутка. Карточки, которые подгружаются только при скролле и не лежат в исходном HTML или на постраничных адресах, дальше первого экрана не видны.
Проверка выглядит так. Сначала логи сервера за две недели: посмотрите, какие боты заходили и с какими кодами ответа. Ошибка 403 или редирект на страницу входа это сигнал.
grep -E "GPTBot|ClaudeBot|PerplexityBot|OAI-SearchBot" access.log
Затем ручной запрос с подменой user-agent:
curl -I -A "GPTBot" https://ваш-сайт.ру/страница
Оговорка от меня: защита по IP может пропустить ваш тестовый запрос и заблокировать настоящего бота, поэтому логи надёжнее, чем curl. В ответе на запрос ищите не только код, но и наличие текста: пустой контейнер вместо содержимого означает, что страница строится скриптом. Для YandexBot полезен «Анализ robots.txt» в Яндекс.Вебмастере.
Когда проблема в измерениях
Иногда трафик «упал» только в отчёте. Проверьте: не задвоен ли счётчик, срабатывают ли цели и события, передаёт ли одностраничный сайт новый просмотр при смене адреса, не теряются ли UTM-метки после редиректа, не искажает ли данные cookie-баннер. Переходы из ИИ-систем могут не фиксироваться отдельно и смешиваться с обычным реферальным трафиком, поэтому отсутствие роста в отчётах не всегда означает, что на сайте что-то сломано.
Шпаргалка
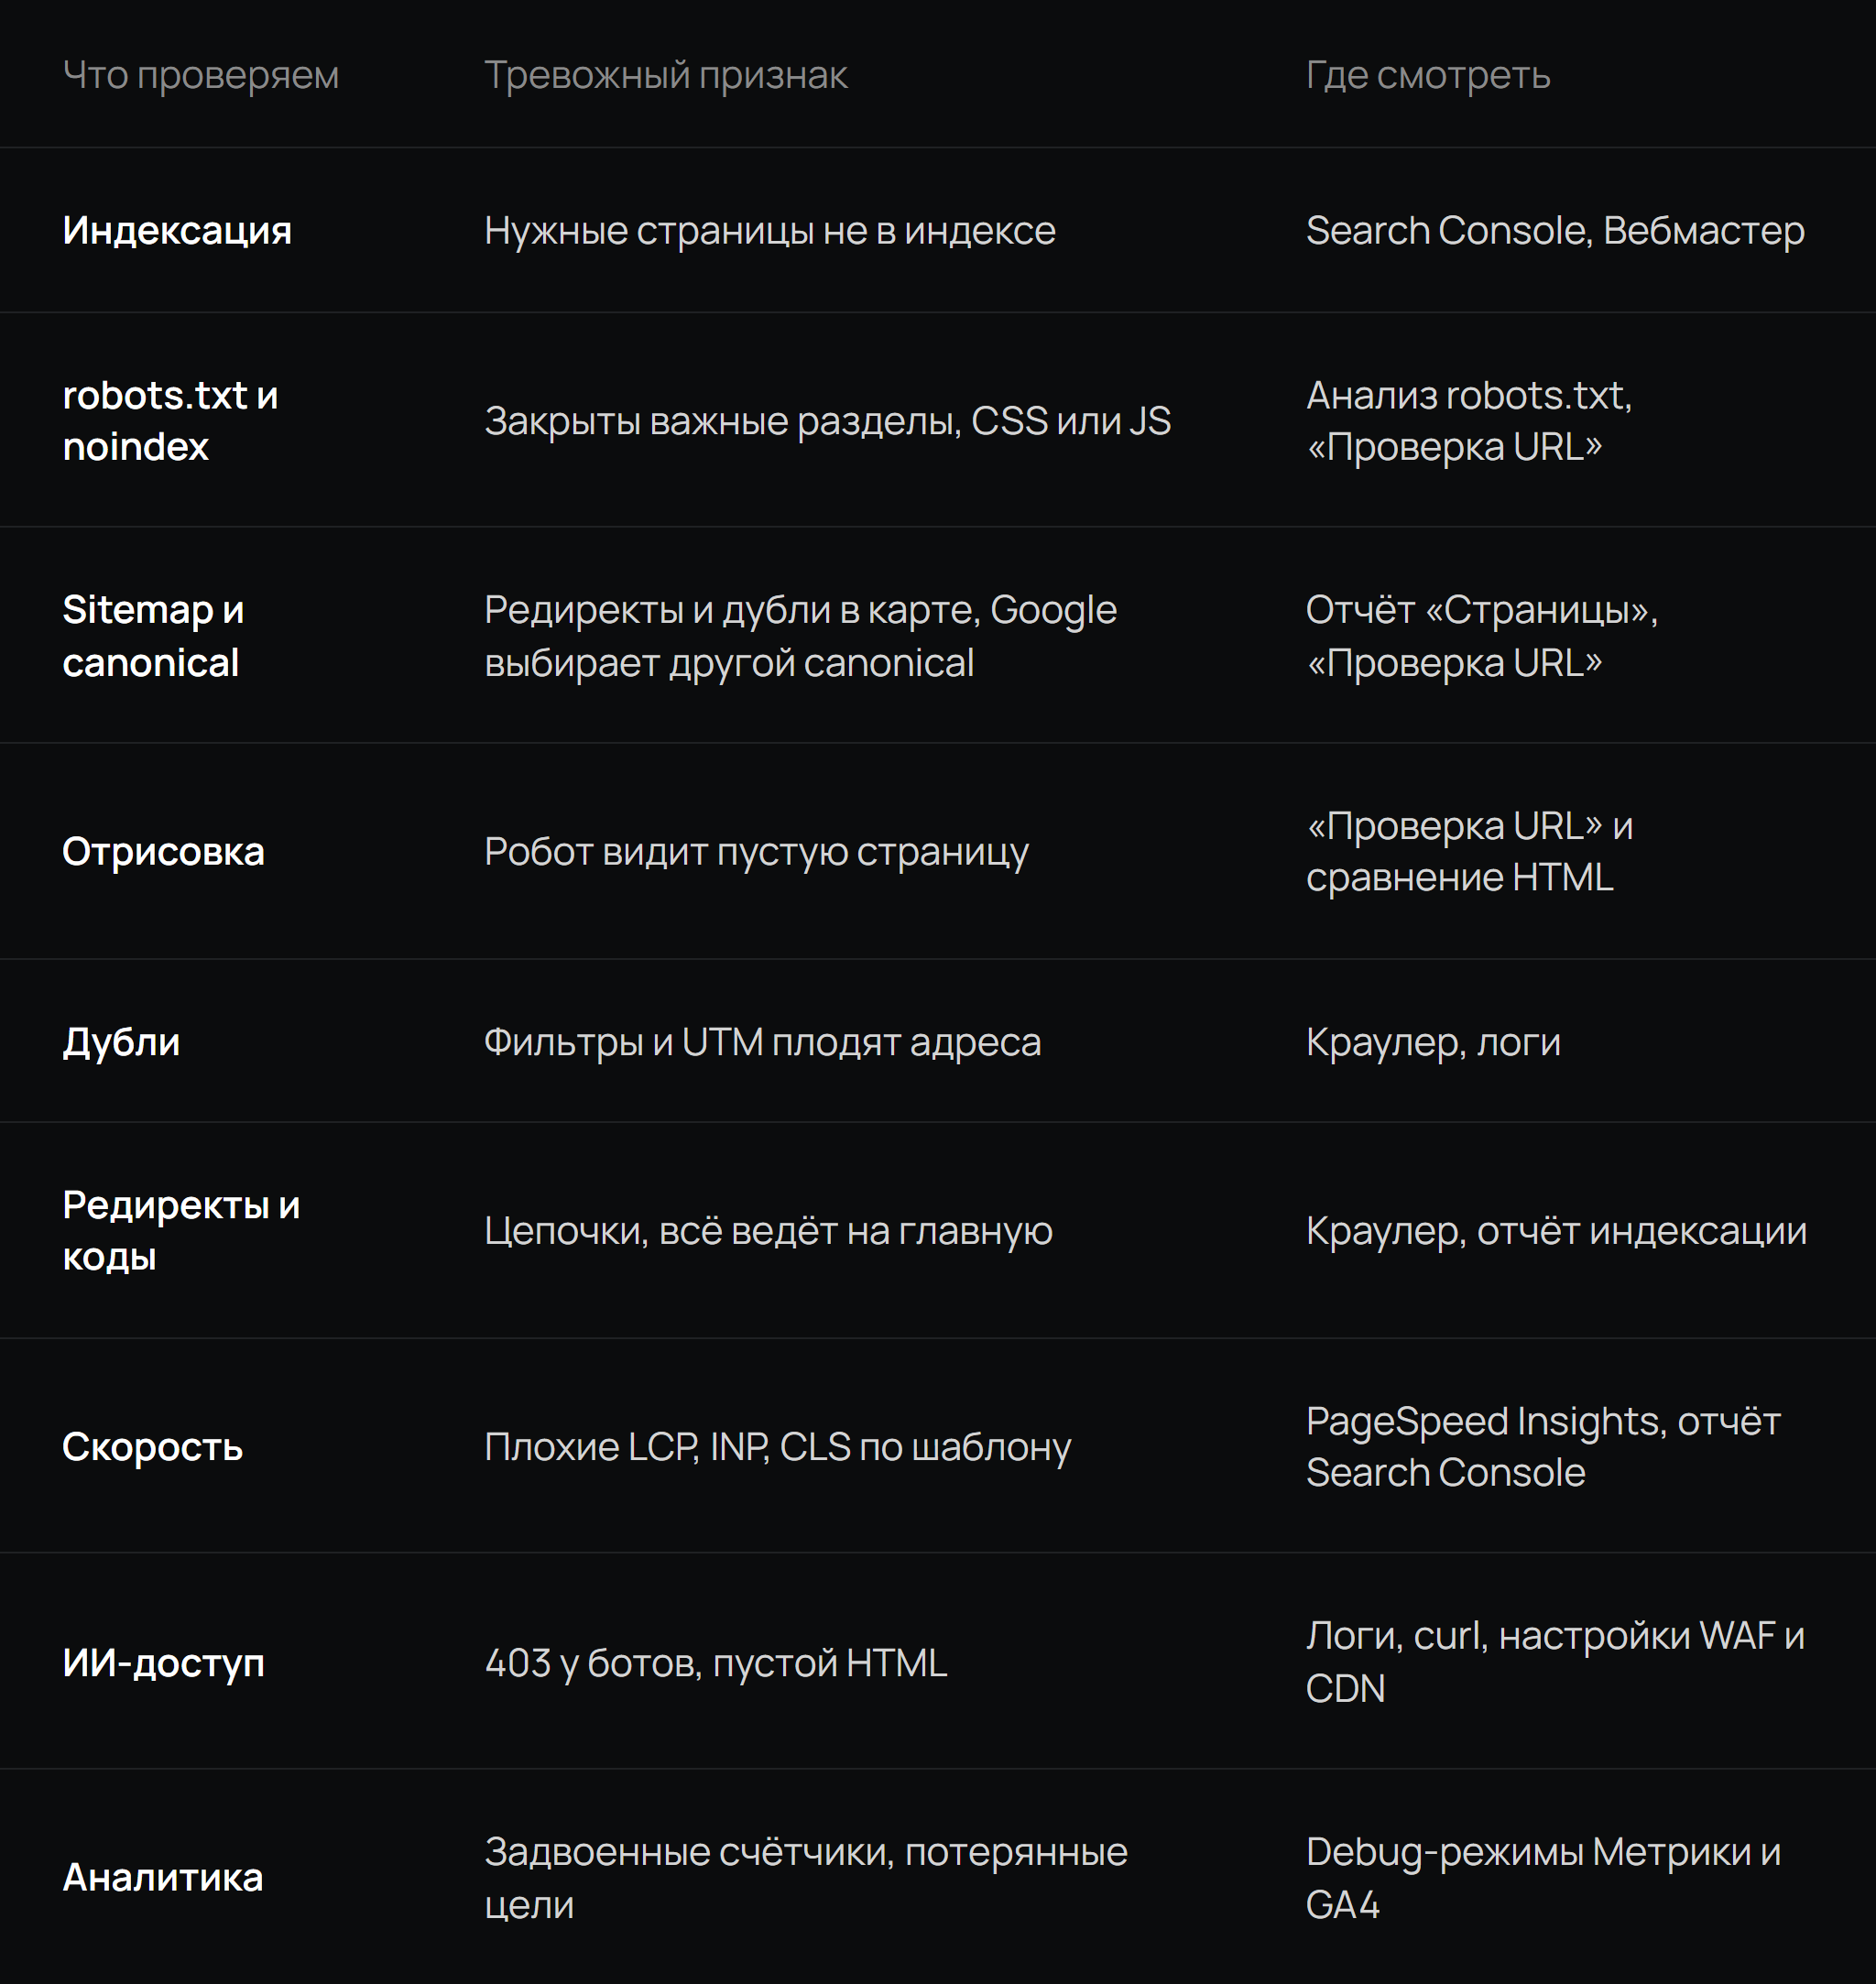
Частые вопросы
Как часто нужен технический аудит?
Экспресс-проверку стоит делать после любого крупного изменения: переезда, редизайна, смены CMS или структуры адресов. Проводите её сразу после релиза и повторяйте через несколько дней, когда поисковики обновят данные. Список ИИ-ботов в robots.txt автор разбора советует сверять раз в квартал.
Можно ли провести аудит самому?
Основное да: отчёты Search Console и Яндекс.Вебмастера, «Проверка URL», PageSpeed Insights и Lighthouse бесплатны. Логи сервера, правила WAF и CDN обычно требуют доступа разработчика или хостинга. Для крупного сайта пригодится краулер вроде Screaming Frog, Sitebulb или Netpeak Spider.
Что делать, если страница «Просканирована, но пока не проиндексирована»?
Заново отправлять запрос на сканирование не нужно. Проверьте, что страница даёт уникальную ценность, на неё ведут внутренние ссылки и она есть в sitemap. Если ничего не изменилось за пару недель, значит вопрос уже не в технике.
Достаточно ли для ИИ-видимости открыть robots.txt?
Нет. Это только первый слой: остаются WAF, CDN, отрисовка на стороне клиента и структура страницы.
Хотите проверить свой сайт?
Мы разрабатываем сайты и внедряем ИИ-решения, поэтому проверяем сайт и глазами поисковика, и глазами нейросети. Посмотрим индексацию, доступ ботов, отрисовку и редиректы и назовём то, что мешает росту, в порядке приоритета.
Напишите нам в мессенджер или оставьте заявку, и мы проведём экспресс-проверку вашего сайта.
Все статьи автора