Синтетические данные для бизнеса: как применять, где возможны ошибки и когда это действительно окупается

О чем статья?
Разработчики просят копию боевой базы, чтобы протестировать новую версию. Юрист против: там персональные данные клиентов. Разработчики отвечают, что без реальных данных проверка ничего не стоит. Оба правы, и спор обычно заканчивается либо тестами на выдуманных трёх строчках, либо утечкой в тестовый контур.
Синтетические данные выглядят выходом из этого тупика. Иногда они им действительно являются. Но ошибок здесь больше, чем обещают продавцы платформ, поэтому начнём с того, что такое эти данные и что о них известно точно.
Что это такое
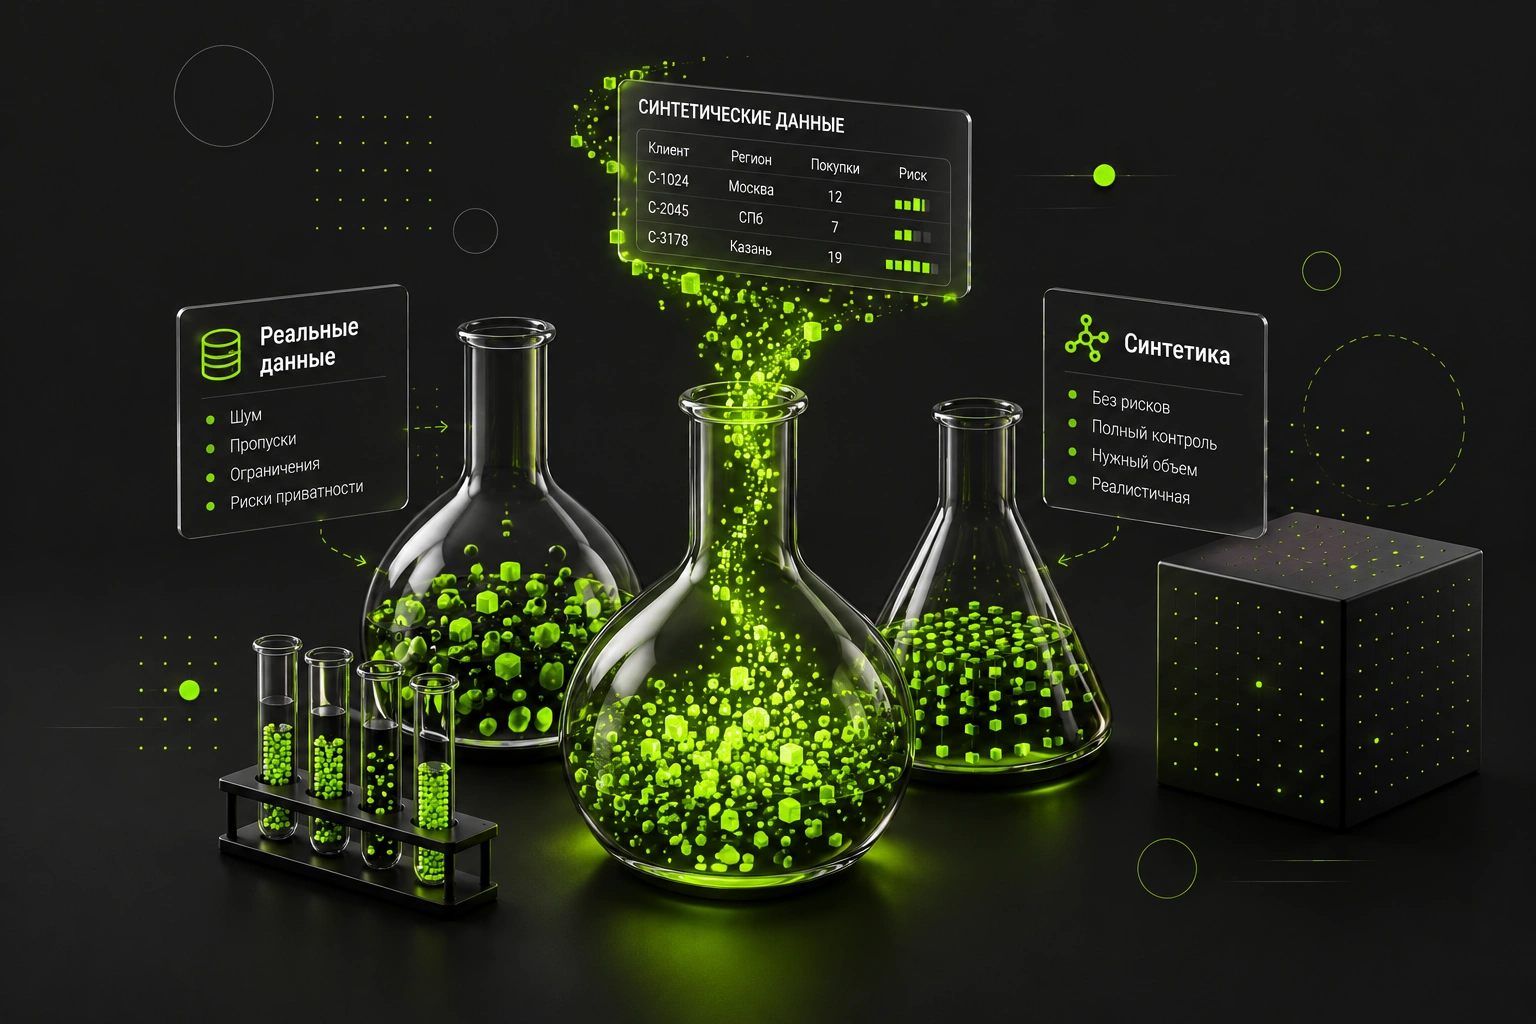
Синтетические данные это искусственно созданные записи, которые повторяют статистику и закономерности реальных, но не содержат конкретных людей и событий. Создают их правилами и формулами, нейросетями (GAN, VAE, диффузионными моделями) или симуляторами. Полностью синтетические наборы дают максимум приватности, но могут терять тонкие зависимости исходных данных.
Рынок пока небольшой: по оценке Global Market Insights, генерация синтетических данных в 2024 году стоила $310,5 млн, а до 2034 года будет расти более чем на 35% в год. Эксперты «Сколково» замечают, что важнее не размер этого рынка, а число ИИ-проектов, которые без синтетики были бы невозможны.
Где синтетика реально работает
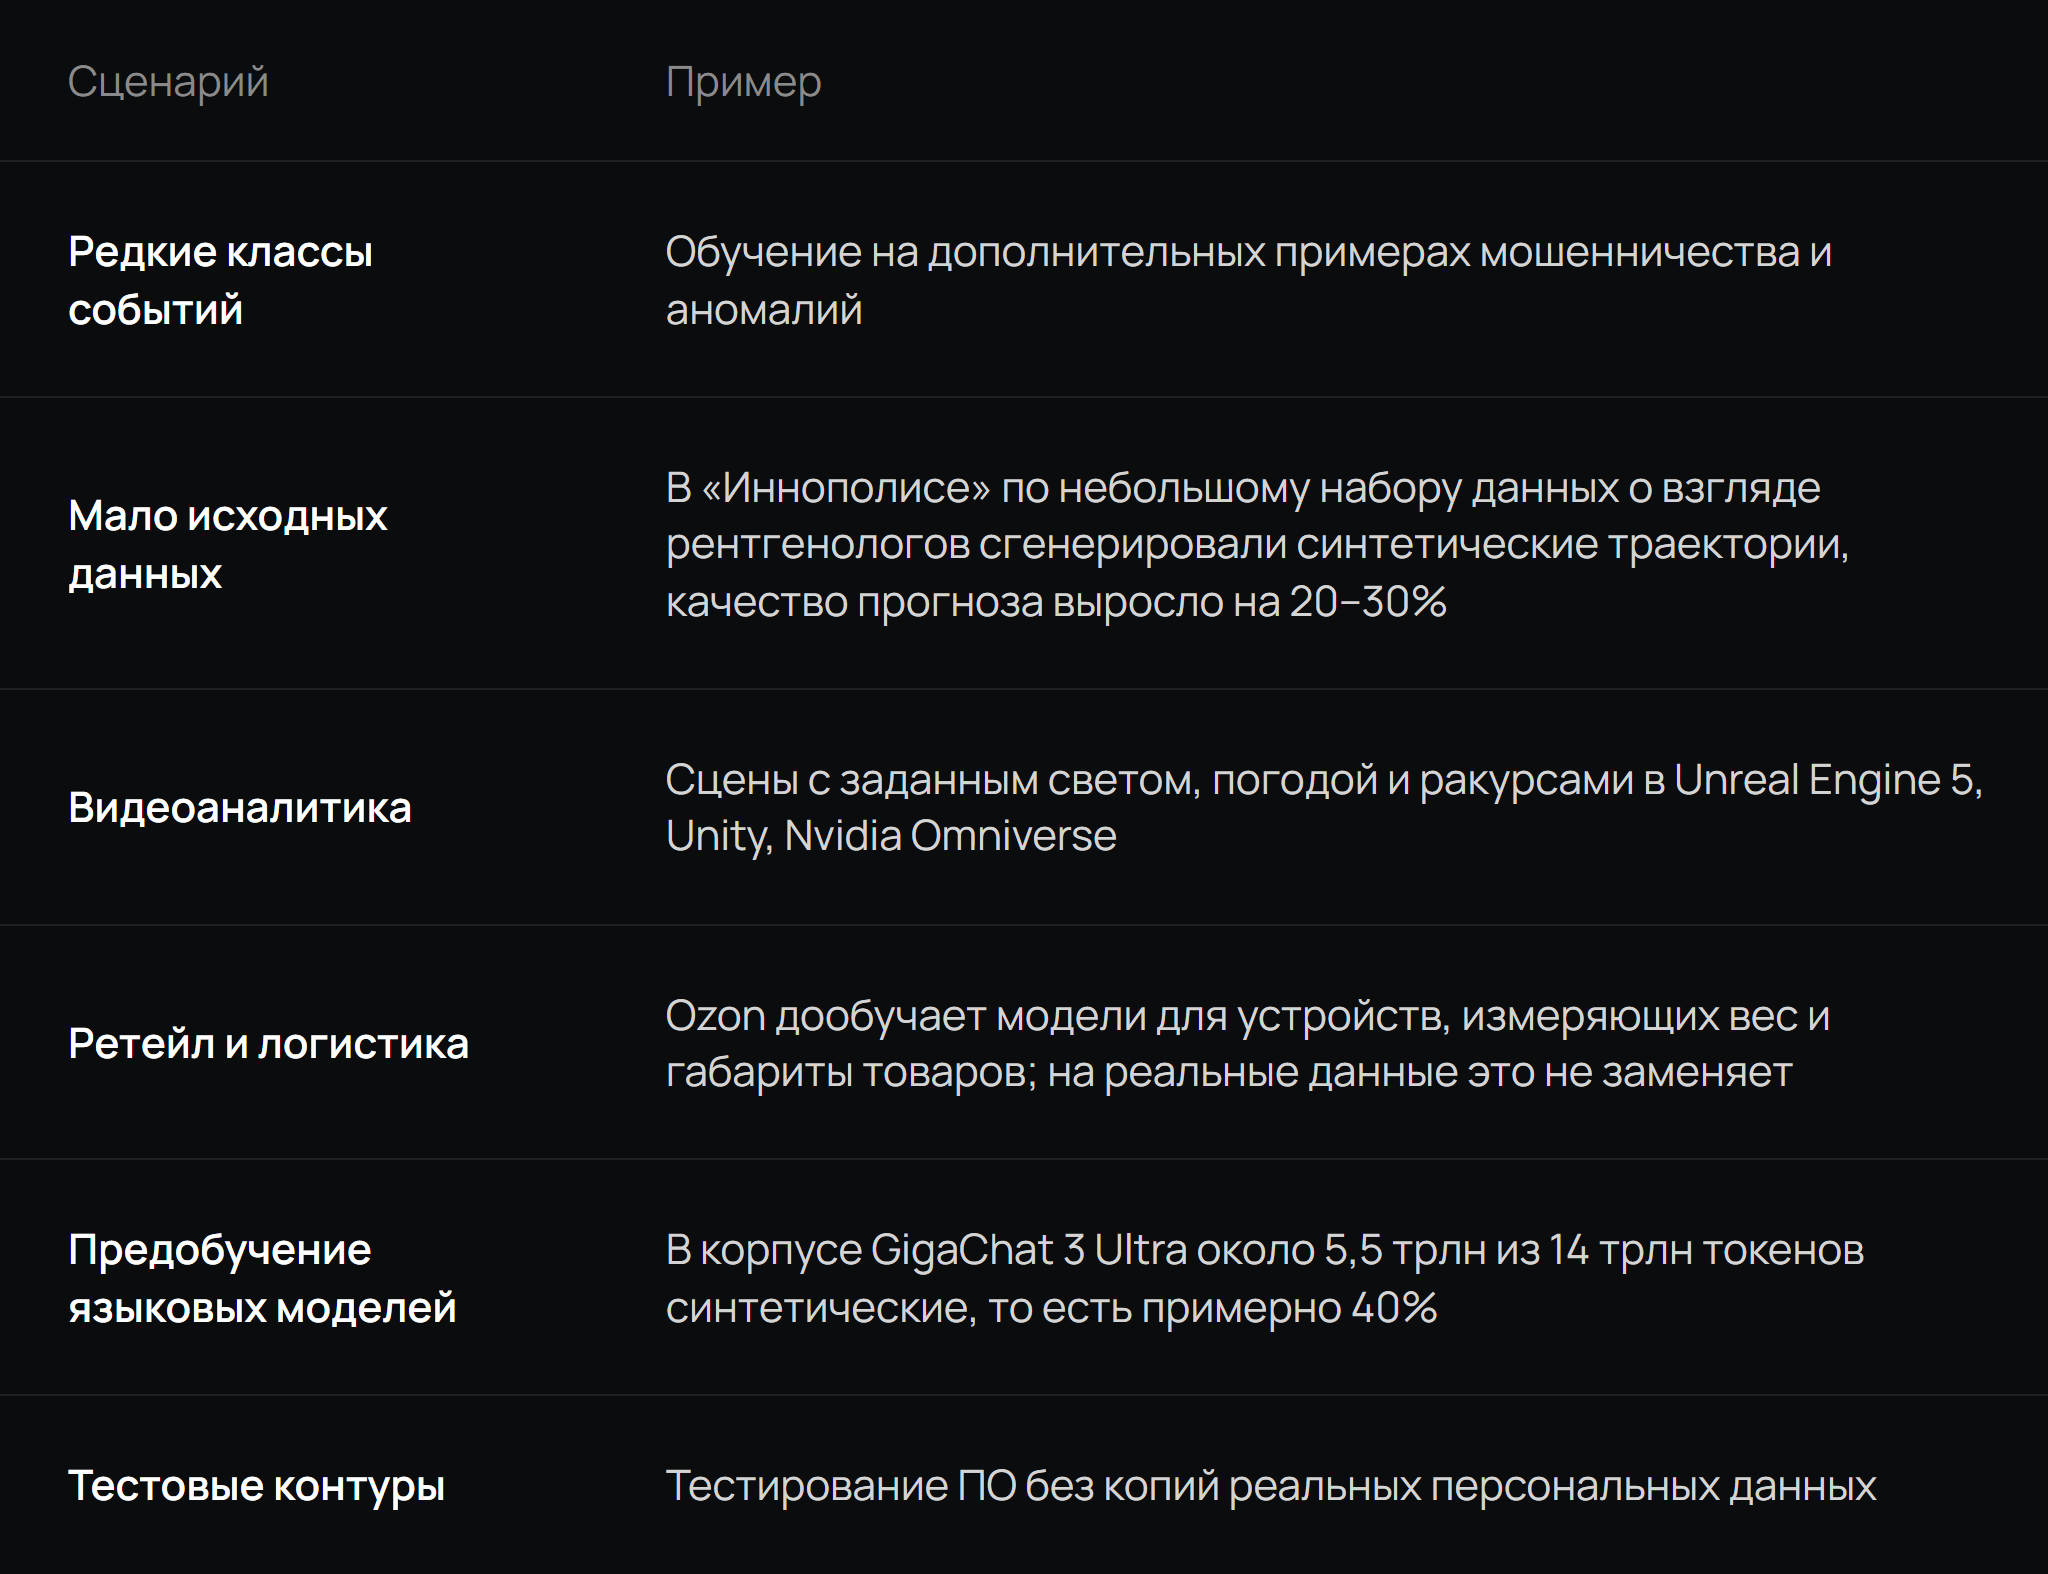
Самый зрелый спрос, по словам консультантов «Яков и Партнёры», в финансах, здравоохранении и промышленности: именно там сходятся чувствительные данные, жёсткая регуляторика и нужда в больших объёмах для обучения.
Где синтетика ломается
Модель забывает реальность
Когда модель обучается в основном на данных, созданных другими моделями, наступает то, что в 2024 году описали учёные Оксфорда и Кембриджа в Nature как «коллапс модели»: алгоритм теряет редкие, но важные значения и транслирует ошибки от поколения к поколению. Неприятная деталь: на стандартных тестах такая модель может продолжать показывать высокие результаты.Часто повторяют, что «5% синтетики портит точность». Стоит знать, откуда это. Эксперт МГТУ им. Баумана Дмитрий Служеникин ссылается на эксперименты Консорциума исследований безопасности технологий ИИ: 5% сгенерированных сообщений в потоке данных заметно снижали точность прогнозов и замедляли поиск аномалий. Это результат для конкретной задачи, а не универсальный порог. Правило про «допустимые 20–30%» я в источниках не нашёл: цифры 20–30% в материалах относятся к приросту качества в проекте «Иннополиса», а не к лимиту доли синтетики. У GigaChat при обучении доля вообще около 40%.
Иллюзия приватности
Здесь источники расходятся. Одни материалы утверждают, что синтетика не позволяет восстановить исходные записи. Консультант «Яков и Партнёры» говорит обратное: при определённых условиях исходные записи можно частично восстановить. Практик описывает проверку, которая снимает спор. Он спрятал в обучающую выборку 500 вымышленных пациентов с редкими фамилиями и диагнозами и после генерации нашёл семь из них почти дословно. Причём метрики похожести при этом выглядели отлично: чем больше модель запомнила, тем красивее метрика. Кейс анонимизирован под NDA, но методика понятна: проверяйте не только «похоже ли», но и «не запомнило ли».Юридический слой
Реальность российского права: если у вас остался ключ обратимости, это по-прежнему персональные данные, даже после маскирования. Тонкости описывает приказ Роскомнадзора от 19.06.2025 № 140 об обезличивании. Отдельно с 1 сентября 2026 года действуют предварительные национальные стандарты ПНСТ 1064-2026, 1065-2026 и 1066-2026 «Синтез данных»: терминология, архитектура с методами синтеза и методика оценки качества. Срок их действия до 1 сентября 2029 года. Это первые документы, на которые можно ссылаться в проектной документации. Регуляторная неопределённость остаётся: в ряде отраслей нет ясности, можно ли обосновывать решения моделью, обученной в основном на синтетике.Технические промахи
Практик, у которого я взял описание кейсов (данные и компании изменены), называет типовые провалы:- Проверяют качество по средним. Среднее совпадает, а форма распределения развалена. В одном описанном кейсе 0,4% мерчантов давали 61% трафика в проде, а на равномерных синтетических данных нагрузка была ровной. Тесты показывали p99 в 180 мс, а прод после релиза выдал 4,2 секунды.
- Забывают воспроизвести пустые значения: в проде 12% пустых полей, в синтетике ноль.
- Убирают все дубли ради «чистоты», хотя система обязана их обрабатывать.
- Генерируют номера без контрольных разрядов: случайный ИНН из двенадцати цифр отбрасывает валидатор примерно в 90% случаев, и вы тестируете свой генератор, а не систему.
Когда это окупается
Для тестовых контуров автор практического разбора формулирует правило: окупаемость начинается, когда выполняются два условия из трёх: над общей моделью данных работают больше пяти команд, данных больше терабайта, есть регулятор. Одного условия мало.
Экономику он предлагает считать по четырём статьям: простой команд в ожидании данных, дефекты, пропущенные из-за нерепрезентативных данных, хранение и сопровождение копий и хвостовой риск утечки. Пример расчёта для 14 команд и 24 спринтов в год: два дня ожидания × 14 команд × 24 спринта × 180 тысяч рублей за день команды получается около 121 млн рублей в год. Это иллюстрация автора, а не рыночный бенчмарк, но метод годится: сначала считаете, сколько стоит ожидание данных сейчас.
Честно о тех, кому не нужно. Три разработчика, два гигабайта данных, один продукт: хватит фикстур и генератора вроде Faker, а нейросетевой синтез станет дорогой игрушкой, которую через полгода некому поддерживать. И ещё одно ограничение, самое важное для решений: «синтетический клиент» не платит деньги и не несёт издержек выбора. Гипотезы о спросе синтетические респонденты помогают отфильтровать, но выводы о готовности платить по-прежнему делают на реальных интервью и продажах.
Пять вопросов, на которые стоит ответить до старта:
1. Какая измеримая задача? «Обучить модель» это не цель.
2. Есть ли качественные исходные данные? Без них генератор бесполезен, а смещённые и устаревшие данные синтетика воспроизведёт и усилит.
3. Кто и как будет проверять результат на реальных данных?
4. Сколько времени и людей выделено? Первый рабочий домен в описанном плане занимает квартал у двух-трёх инженеров.
5. Что делаете, если качество упало? Нужен план отката и дообучения на реальной выборке.
Как проверять качество
Единого стандарта долго не было, что и отметили эксперты в июне 2026 года. С 1 сентября действует ПНСТ 1066-2026 с методикой оценки качества. На практике смотрят три вещи: правдоподобие (похожи ли распределения и корреляции), разнообразие (есть ли редкие случаи) и полезность (решает ли синтетика задачу не хуже реальных).
Главная проверка одна: модель, обученную на синтетике, тестируют на реальных данных, которые в обучении не участвовали. Если долю синтетики снижают после падения качества, значит, граница нащупана экспериментом. Для видеоаналитики новую модель запускают в теневом режиме параллельно с работающей системой, и её выводы не влияют на процессы. В медицине и финансах применяют слепые экспертные оценки. Для приватности добавляйте проверку на запоминание, как в описанном примере с вымышленными пациентами.
Частые вопросы
Можно ли заменить реальные данные синтетическими полностью?
Нет. Граница зависит от цели: при предобучении языковой модели синтетика бывает около 40% корпуса, а в системах управления беспилотным транспортом или критической инфраструктурой её доля строго ограничена. Реальные данные остаются способом проверить, что модель соответствует миру.
Подходит ли это малому бизнесу?
Зависит от задачи. Для тестирования небольшой системы часто достаточно генераторов тестовых данных. Для ИИ-моделей нужны хорошие исходные данные: чем меньше их у вас, тем выше риск, что синтетика размножит ошибки.
Как проверить, что синтетика не искажает модель?
Тестируйте на реальных данных, которых не было в обучении. Сравнивайте перцентили и форму распределения, а не только средние. Прогоните проверку на запоминание.
Синтетические данные безопасны с точки зрения закона?
Не автоматически. Обратимое маскирование не выводит данные из-под 152-ФЗ, а из плохо сделанной синтетики можно частично восстановить исходные записи. Юридическую оценку делайте отдельно для вашего случая.
Хотите понять, поможет ли синтетика в вашей задаче?
Мы внедряем ИИ-решения и знаем, что чаще всего вопрос не в генерации данных, а в том, что именно вы хотите получить. Если у вас упёрлись обучение или тестирование в нехватку или закрытость данных, можем разобрать задачу и сказать, нужна ли вам синтетика или достаточно более простых решений.
Напишите нам в мессенджер или оставьте заявку, и мы обсудим ваш случай и дадим конкретную рекомендацию.
Все статьи автора