Как эффективнее расходовать токены нейросетей

О чем статья?
Один тест, который разработчики редко делают: посчитать счёт по прайсу, а потом сравнить с тем, что реально списали. В прогоне AI Dev Team фактическое списание за модель GLM-5.2 вышло на 108% выше расчёта. Маршрутизатор увёл запросы к другому провайдеру с другой ценой. Модель та же, ответы те же, а счёт вдвое больше.
Токены дорожают не только из-за объёма работы. На сумму влияют модель, длина ответа, кэш, порог по длине контекста и даже то, куда уходит запрос. Ниже разберём, что из этого реально двигает счёт и сколько можно сэкономить, а где обещания сильно приукрашены.
Из чего складывается счёт
Токен — кусочек текста примерно в 3–4 символа русского языка; миллион токенов это порядка 700–750 тысяч слов. Платите вы за две вещи по разным ставкам: за входные токены (всё, что вы отправили: промпт, историю, документы) и за выходные (то, что модель написала в ответ).
Выходные стоят кратно дороже. Вот ставки за миллион токенов из каталога российского агрегатора на 29 мая 2026 года (цены провайдеров в рублях):
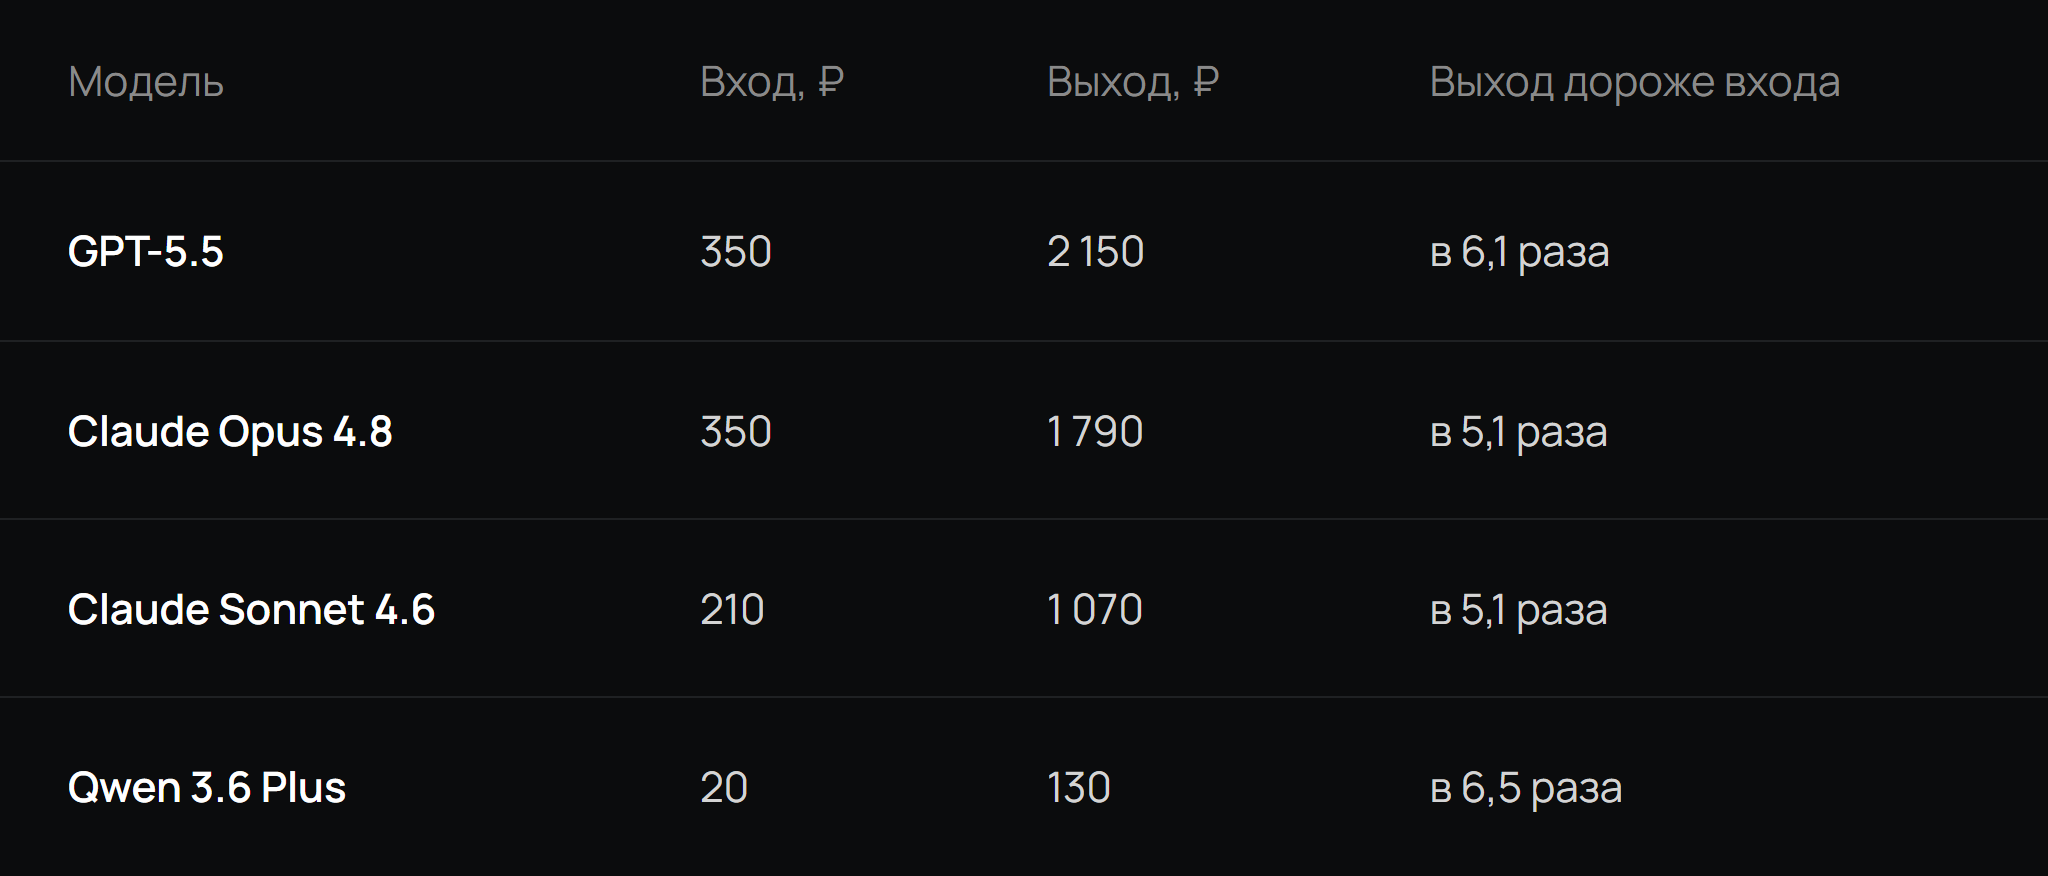
Источник: каталог агрегатора provod.ai.
Отсюда простой вывод: тратите вы в основном на то, что модель пишет, а не на то, что читает. Пример на GPT-5.5 ($5 за миллион входных и $30 выходных): запрос на 2 000 входных и 500 выходных токенов стоит 0,01 плюс 0,015, то есть около 2,5 цента, примерно 1,8 рубля. Выход даёт 60% этой суммы, хотя токенов в нём в четыре раза меньше.
Как снизить расходы
Подбор модели под задачу
Самый сильный рычаг и самый простой. Классификация, извлечение полей, модерация и короткие ответы FAQ-бота одинаково хорошо решаются и дешёвой моделью, и флагманом. Разница в цене при этом огромная.Осторожно с цифрой «в 35 раз», которую любят повторять. Она посчитана по DeepSeek V4 Pro с промо-скидкой 75%, которая действовала до 31 мая 2026 года. После промо ставка вернулась примерно к $1,74 за вход и $3,48 за выход. Против $30 у GPT-5.5 разница на выходе получается порядка девяти раз (мой расчёт). Это всё равно много, но не тридцать пять.
Флагман имеет смысл оставлять для сложного рассуждения, агентных цепочек и задач, где ошибка дорого стоит. Качество на своих данных проверяйте сами: разрыв между дешёвой и дорогой моделью бывает как ничтожным, так и решающим, в зависимости от задачи.
Кэширование промпта
Провайдер запоминает уже обработанное начало запроса и при повторе берёт за него меньше. У OpenAI на GPT-5.5 кэшированный вход стоит $0,50 вместо $5 за миллион, то есть скидка 90%; у GPT-5.4 $0,25 вместо $2,50. У Anthropic чтение из кэша стоит 0,1 от обычной ставки, а запись дороже: 1,25× для пятиминутного кэша и 2× для часового. У OpenAI отдельной платы за запись нет, кэш включается автоматически. На старых моделях OpenAI (gpt-4o, gpt-4.1) скидка меньше, около 50%.Теперь главное, о чём молчат рекламные тексты. Скидка «90%» относится только к кэшированной части входа. В расчёте ofox на 10 000 запросов в день с 5 000 кэшируемых токенов, кэшем в 80% попаданий и выходом в 1 000 токенов на запрос экономия составила около 31–32% от всего дневного счёта, а не 90%. Причина: выход дорогой и кэшем не удешевляется, а запись в кэш тоже стоит денег. Расчёт иллюстративный, цены в нём условные, но логика верна для любого чат-бота.
Кэш чаще всего ломают сами разработчики. Три типичные причины из разбора практики:
- В системный промпт вставили текущую дату или идентификатор запроса. Начало запроса меняется каждый раз, кэш не срабатывает никогда.
- Определения инструментов собираются в разном порядке на разных серверах.
- История диалога режется скользящим окном, и после заполнения окна префикс каждый раз новый.
Правило одно: неизменное кладите в начало запроса, переменное в конец. Минимальный размер кэшируемого блока зависит от модели и составляет от 1 024 до 4 096 токенов. Источники расходятся в деталях по отдельным моделям Claude, поэтому цифру для вашей модели сверяйте с документацией провайдера.
Маршрутизация между моделями
Слой перед моделями оценивает сложность запроса и отправляет простое на дешёвую, сложное на флагман. Если дешёвая справилась плохо, запрос уходит наверх.Считаем на примере: 100 000 запросов в месяц, по 1 000 входных и 1 000 выходных токенов. Всё на GPT-5.5 стоит по выходу 215 000 рублей. Если 80% трафика уйдёт на DeepSeek по ставке после окончания промо (около 250 рублей за миллион выходных), а 20% останутся на флагмане, выход обойдётся примерно в 63 000 рублей, то есть на 71% дешевле. Исходный расчёт агрегатора давал 78%, но он опирался на промо-цену. Мой пересчёт уже с базовой ставкой. Допущение здесь одно и важное: 80% ваших запросов действительно простые и дешёвая модель справляется с ними так же.
Контроль выхода и длины контекста
Выход дорогой, поэтому его ограничивают. Параметр max_tokens надёжнее просьбы «отвечай кратко». Из контекста уберите лишнее: вместо договора на 400 страниц отправляйте нужный раздел, вместо всей переписки последние сообщения плюс краткую сводку старых.Есть две ловушки. Первая: у некоторых моделей тариф молча повышается при длинном входе. У GPT-5.5 и GPT-5.4 порог 272 000 входных токенов, после него ставка вырастает вдвое на вход и в полтора раза на выход. У Qwen3.7 Flash первый порог наступает уже на 32 тысячах токенов, и цена вырастает с $0,03 до $0,10 за миллион, то есть втрое. Это обычный рабочий промпт агента с историей и парой документов. Вторая ловушка: режим рассуждений. Модель «думает» перед ответом, и эти токены вы оплачиваете как выход. У gpt-oss-120b доля рассуждений в оплаченном выводе при смене уровня effort выросла с 8% до 74%, а цена за тот же набор задач в 3,9 раза. Две другие модели в том же тесте параметр практически проигнорировали. Долю рассуждений надо мерить на своей модели.
Пакетная обработка и экономкласс
Если ответ нужен не сию секунду (ночная разметка, массовая генерация описаний, прогоны тестов), используйте batch-режим. Batch API Anthropic даёт скидку 50%, большинство пачек обрабатывается меньше часа, гарантия завершения 24 часа. Близкая по идее история у экономкласса OpenAI: он вдвое дешевле стандартного и в тесте не был медленнее на коротких ответах, но под нагрузкой оказался менее стабилен, поэтому нужны повторные попытки и запасной путь в обычный класс. Для чата, где пользователь ждёт ответа, ни то ни другое не подходит.Чего делать не стоит
Совет «включите режим самого дешёвого провайдера» в измерении AI Dev Team экономии не дал: цена вызова получилась на 5% выше, чем без настройки. Маршрутизация и без этой опции склоняется к дешёвым серверам, а принудительный выбор убирает учёт их доступности.
Ещё одна привычка: считать бюджет по прайсу и не смотреть на факт. Пишите в лог, какой провайдер обработал каждый запрос, и сверяйте с реальным списанием. Пока расходы не измеряются, оптимизировать нечего.
И третье: жёсткие лимиты на аккаунте ставьте в первую же неделю. Практики начинают контроль расходов на API именно с бюджета и потолков.
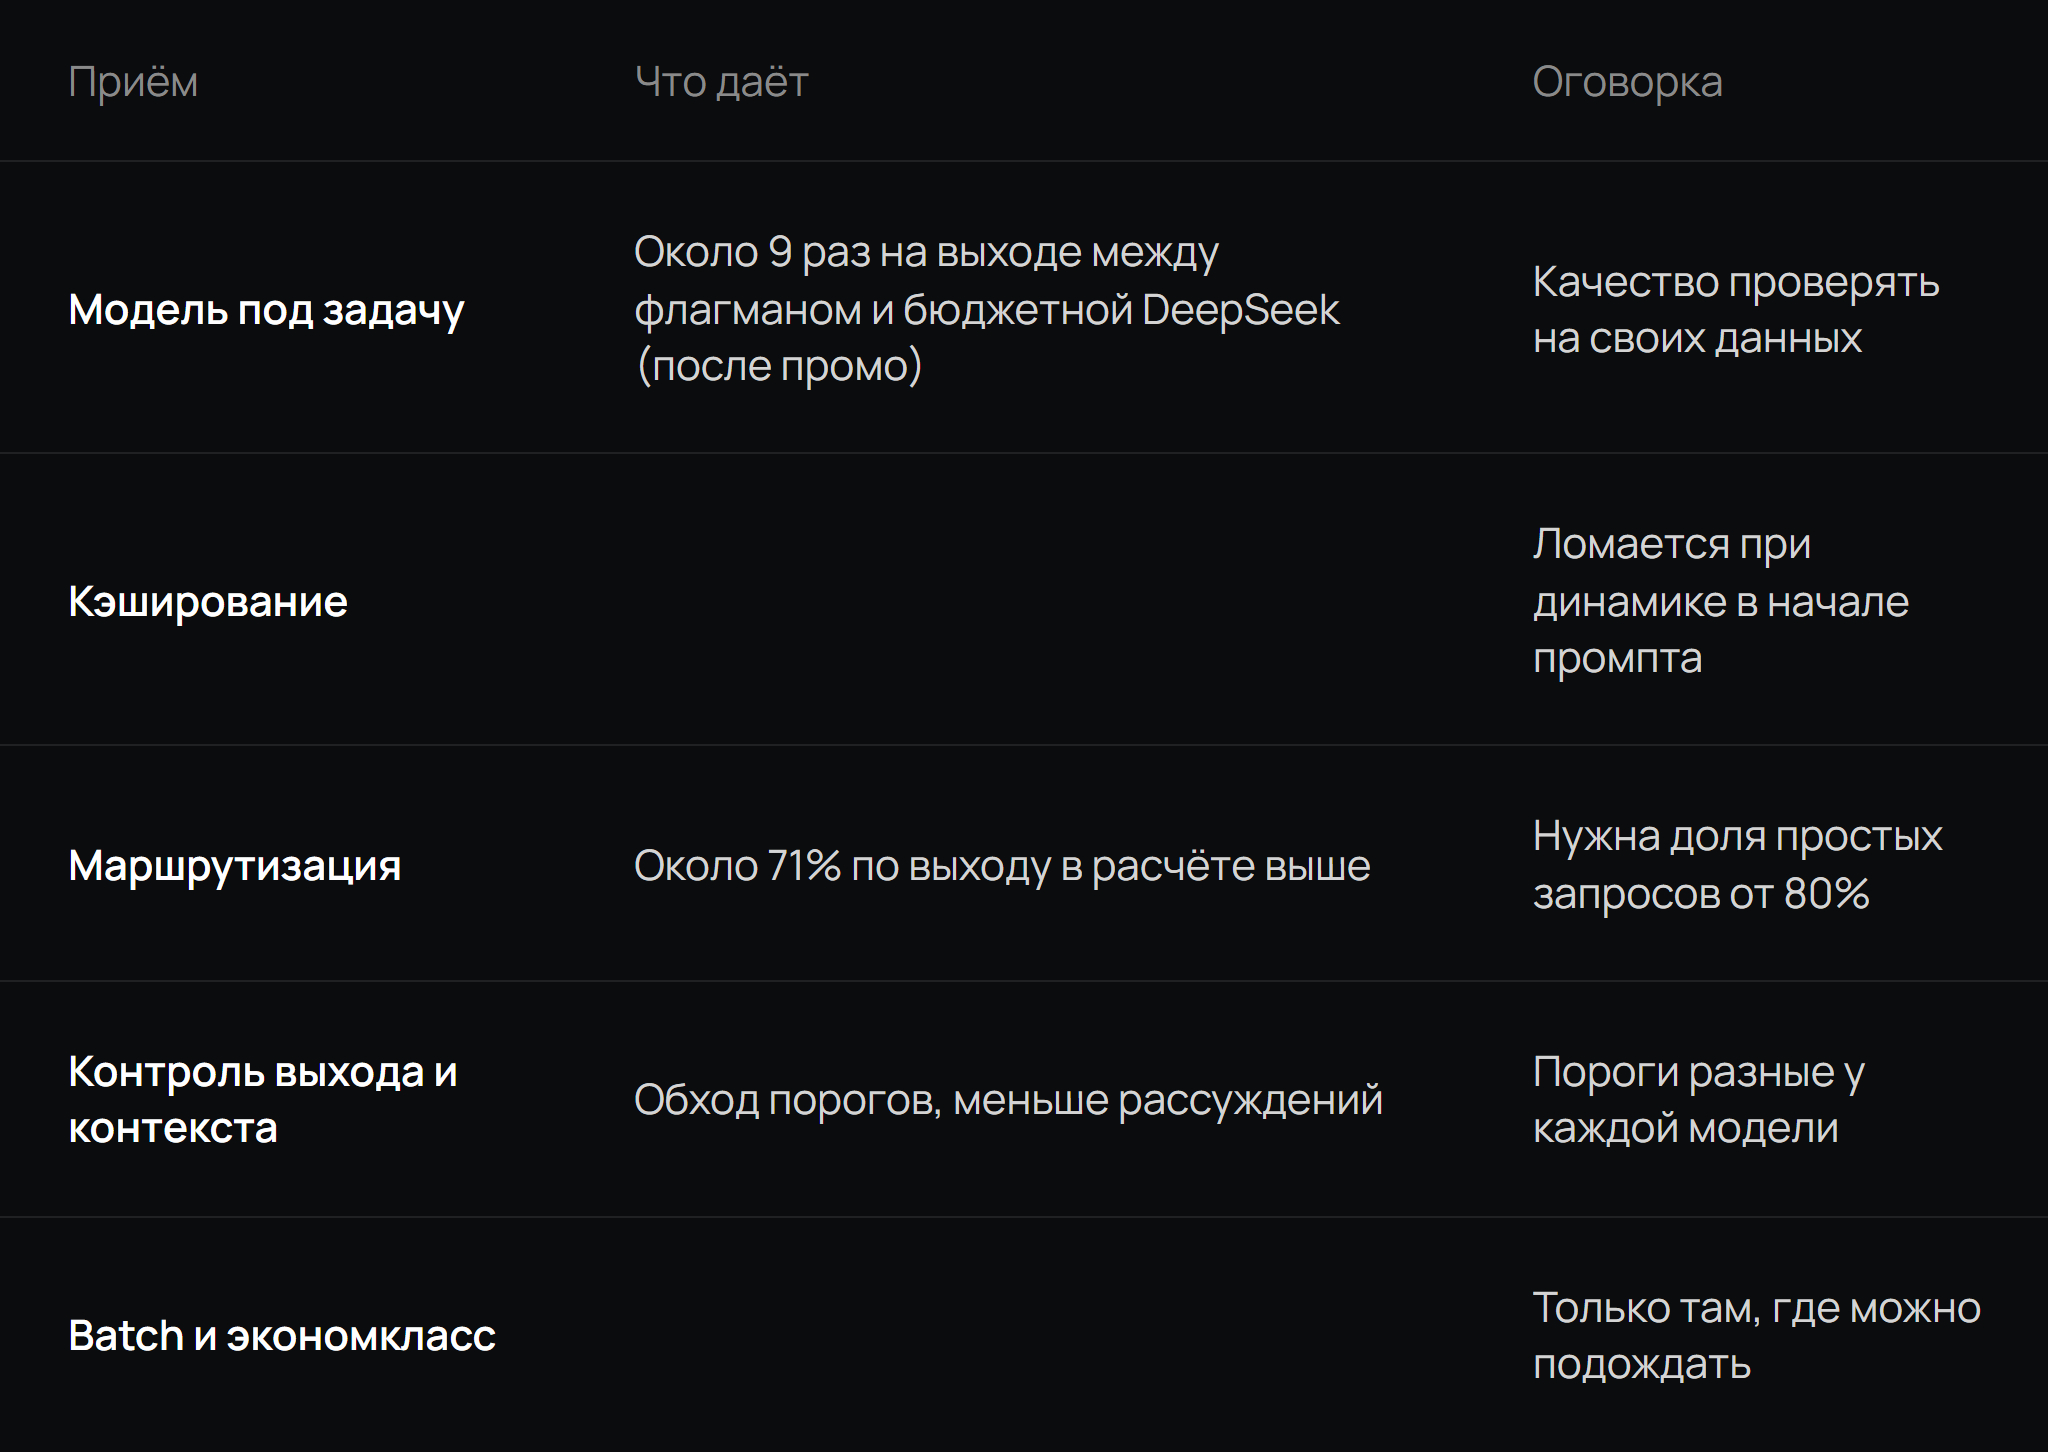
Сводка по приёмам
Когда это критично для бизнеса
Если токены идут в продукт (ИИ-агент, бот поддержки, автоматизация документов), стоимость одного диалога входит в юнит-экономику. Продукт с грамотным кэшем и маршрутизацией и продукт, где всё гонят через самую дорогую модель, к тысячному клиенту получают разную маржу. Считайте себестоимость диалога до запуска, а не по первому счёту.
FAQ
Сколько стоит один запрос к нейросети?
Считайте по формуле: входные токены умножить на ставку входа плюс выходные на ставку выхода. Для GPT-5.5 запрос на 2 000 входных и 500 выходных токенов обходится в 2,5 цента, около 1,8 рубля. Ставки меняются, поэтому берите актуальные из прайса провайдера с датой.
Можно ли верить расчёту по прайсу?
Нет, только как ориентиру. Реальный счёт зависит от провайдера, класса обслуживания, кэша и порогов по длине контекста. В тесте AI Dev Team фактическое списание превысило расчёт на 108%. Сверяйте расчёт с фактом каждую неделю.
Дешёвая модель сильно хуже флагмана?
На простых задачах разница часто не заметна, на сложных может быть решающей. Проверьте на 50–100 своих реальных запросах: если дешёвая справляется, разницу в цене можно оставить себе.
С чего начать, если счёт уже вырос?
Начните с измерений: включите лог провайдера и фактического списания. Потом проверьте порог по длине контекста и что стоит в начале промпта. Только после этого меняйте модели.
Счет за нейросети растет быстрее выручки?
Мы разрабатываем ИИ-агентов и ботов и считаем экономику диалога ещё до запуска. Если у вас уже работает продукт на нейросети и счёт растёт быстрее выручки, можем посмотреть схему запросов и показать, где утекают деньги.
Напишите нам в мессенджер или оставьте заявку, разберём вашу нагрузку и предложим конкретную схему.
Все статьи автора